KI im Scouting: Daten, Modelle und Grenzen der Talentsichtung
KI im Scouting bedeutet vor allem: große Mengen an Spiel- und Videodaten durchsuchen, Spielerprofile vergleichen und Kandidaten vorschlagen, die ein Mensch dann genauer ansieht. Das spart Zeit und erweitert den Blick. Gleichzeitig übernehmen Modelle die Verzerrungen ihrer Daten, im Jugendfußball vor allem den relativen Alterseffekt und Unterschiede in der biologischen Reife. Wer Daten nutzt, muss diese Fehler kennen und gezielt gegensteuern.
Organisieren Sie Turniere? Erstellen Sie Ihres kostenlos auf DorsalCUP.
In diesem Artikel
- Wie KI im Scouting heute eingesetzt wird
- Scouting-Daten im Fußball: was Kennzahlen messen und was nicht
- Talentsichtung in der Jugend: relativer Alterseffekt und Reife
- Verzerrungen und Fehler in Scouting-Modellen
- Ethik und Recht: Profiling, DSGVO und AI Act
- So sichtet ein kleiner Verein strukturiert und fair
Wie KI im Scouting heute eingesetzt wird
Im Profibereich basiert datengestütztes Scouting auf zwei Arten von Daten. Ereignisdaten beschreiben, was mit dem Ball passiert: Pässe, Dribblings, Schüsse, Zweikämpfe, jeweils mit Ort und Zeit. Trackingdaten beschreiben, wo sich alle Spieler und der Ball zu jedem Zeitpunkt befinden, meist mehrfach pro Sekunde. Aus beiden lassen sich Kennzahlen berechnen, die ein Scout im Stadion nicht zählen kann.
KI kommt an drei Stellen ins Spiel:
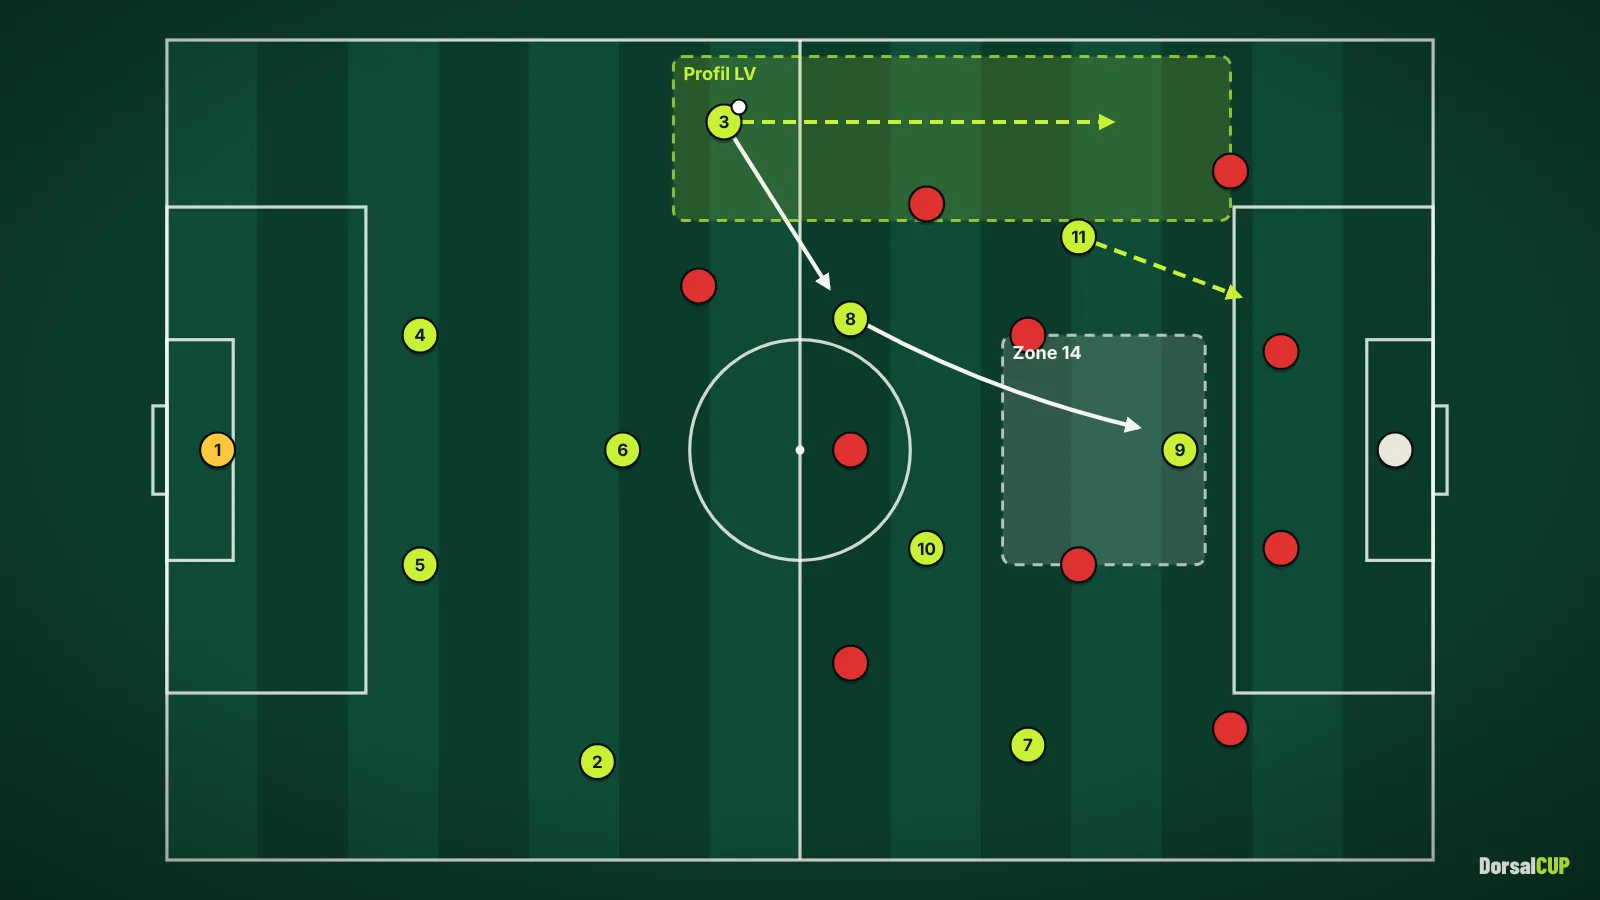
- Ähnlichkeitssuche: Ein Modell findet Spieler, deren statistisches Profil einem Vorbild ähnelt, etwa einem Außenverteidiger, der viel in den Halbraum einrückt.
- Rollenbewertung: Spieler werden nicht nach Position, sondern nach Aufgaben bewertet, zum Beispiel „ballführender Innenverteidiger“ oder „pressingstarker Flügelspieler“.
- Videosuche: Software sucht automatisch alle Szenen eines Spielers heraus, etwa alle Ballannahmen unter Druck, und verkürzt so die Sichtungszeit.
Im Amateur- und Jugendbereich fehlen diese Daten meist. Dort stammen die Informationen aus eigener Videoaufnahme, Sichtungsbögen und Turnieren. Die Methode bleibt dieselbe: erst eingrenzen, dann gezielt hinsehen. Wie man aus eigenen Aufnahmen Daten gewinnt, beschreibt der Beitrag zur KI-Videoanalyse.
Scouting-Daten im Fußball: was Kennzahlen messen und was nicht
Jede Kennzahl hängt vom Kontext ab: Liga, Spielstil der Mannschaft, Rolle des Spielers, Spielstand. Ein Sechser in einer dominanten Mannschaft spielt mehr Pässe als einer in einem tiefen Block; das sagt wenig über seine Qualität aus.
| Kennzahl | Was sie zeigt | Typische Fehlinterpretation |
|---|---|---|
| Progressive Pässe | Wie oft der Spieler den Ball deutlich Richtung Tor bewegt | Hohe Werte in Teams mit viel Ballbesitz, niedrige im Konterteam |
| Erwartete Tore (xG) | Qualität der Abschlusspositionen | Wenige Spiele, hohe Streuung; Modell aus anderer Liga |
| Ballgewinne im Angriffsdrittel | Pressingbeteiligung | Hängt stark vom Pressingplan des Trainers ab |
| Sprints pro Spiel | Wiederholte hohe Intensität | Abhängig von Rolle, Spielverlauf und Messsystem |
| Zweikampfquote | Anteil gewonnener Duelle | Belohnt Spieler, die nur sichere Duelle führen |
Die nützlichste Frage ist daher nicht „Wer hat die besten Werte?“, sondern „Welche Aufgaben braucht unsere Spielidee in dieser Rolle, und welche Daten beschreiben sie?“. Ein Verein, der flach aufbaut, braucht Innenverteidiger, die unter Druck aufdrehen können; ein Verein mit tiefem Block und Konter braucht andere Profile.
Talentsichtung in der Jugend: relativer Alterseffekt und Reife
Im Jugendfußball messen Daten oft nicht Talent, sondern Entwicklungsvorsprung. Ein Kind, das im Januar geboren ist, ist in derselben Altersklasse fast ein Jahr älter als eines vom Dezember. Dazu kommen Unterschiede in der biologischen Reife, die in der Pubertät mehrere Jahre betragen können. Größere, schnellere, kräftigere Spieler gewinnen mehr Zweikämpfe, sprinten schneller und werden häufiger ausgewählt.
Eine Untersuchung der Universität Halle-Wittenberg zur Saison 2022/23 hat die Kader der U17- und U19-Bundesliga sowie der 3. Liga ausgewertet. In der U17 waren knapp 44 Prozent der Spieler im ersten Quartal geboren und nur gut 9 Prozent im letzten; in der Bevölkerung liegen beide Quartale bei rund einem Viertel. Bei den älteren Spielern der 3. Liga war der Effekt deutlich schwächer. Das heißt: Viele spät geborene Spieler werden früh aussortiert, obwohl ihre Chancen im Erwachsenenbereich nicht schlechter sind.
Für KI-Modelle ist das ein Kernproblem. Ein Modell, das mit früheren Auswahlentscheidungen trainiert wird, lernt, dass frühe Geburtsmonate und körperliche Werte „erfolgreich“ sind, und verstärkt den Effekt. Gegenmaßnahmen:
- Geburtsquartal immer mit erfassen und Leistungswerte innerhalb des Jahrgangs nach relativem Alter einordnen.
- Biologische Reife berücksichtigen, etwa über die vom Fachpersonal geschätzte voraussichtliche Erwachsenengröße; Sichtungen in nach Reife gebildeten Gruppen (Bio-Banding) ergänzen.
- Technisch-taktische Merkmale stärker gewichten als Sprintwerte und Zweikampfquoten.
- Den eigenen Kader prüfen: Wie verteilen sich die Geburtsquartale in den Leistungsteams des Vereins? Eine starke Schieflage ist ein Warnsignal.
Verzerrungen und Fehler in Scouting-Modellen
Neben dem Alterseffekt gibt es weitere typische Fehlerquellen, die man kennen sollte, bevor man einer Rangliste glaubt.
Ein konstruiertes, aber typisches Beispiel: Ein Modell bewertet U13-Spieler anhand von Sprintzeiten, Zweikampfquote und Toren. Ganz oben stehen fast nur körperlich frühreife Jungen aus dem ersten Halbjahr. Ein kleiner, spät geborener Spieler, der im Spiel ständig die richtige Anschlussaktion wählt, landet im Mittelfeld der Liste und wird nicht eingeladen. Der Fehler liegt nicht im Rechnen, sondern in der Auswahl der Merkmale.
- Überlebensverzerrung: Modelle lernen aus Spielern, die es geschafft haben. Wer früh aussortiert wurde, taucht in den Daten nicht auf.
- Ligaeffekte: Werte aus einer schwächeren Liga lassen sich nicht direkt auf eine stärkere übertragen; Umrechnungsfaktoren sind Schätzungen.
- Kleine Stichproben: Fünf Spiele mit vielen Toren sind kein Muster. Besonders in der Jugend schwanken Leistungen von Woche zu Woche.
- Fehlender Kontext: Daten wissen nicht, dass ein Spieler krank war, auf ungewohnter Position spielte oder in einem neuen Team stand.
- Scheingenauigkeit: Eine Bewertung von 78,4 Punkten wirkt präzise, beruht aber auf vielen Annahmen.
Die Konsequenz ist nicht, auf Daten zu verzichten, sondern sie als Filter zu nutzen: Sie erweitern die Liste der Kandidaten und lenken den Blick. Die Entscheidung entsteht im Training, im Spiel, im Gespräch mit Spieler und Eltern.
Die Turnierorganisation gehört zu den zeitaufwendigsten Aufgaben im Amateurverein: Anmeldungen, Auslosung, Spielplan und Ergebnisse. DorsalCUP erledigt das kostenlos, und der Spielplan-Generator erstellt den Spielplan eines Turniertags in wenigen Minuten, ohne Anmeldung.
Ethik und Recht: Profiling, DSGVO und AI Act
Die Bewertung von Spielern anhand ihrer Daten ist rechtlich ein Profiling im Sinne der DSGVO. Artikel 22 gibt Betroffenen das Recht, keiner ausschließlich automatisierten Entscheidung unterworfen zu werden, die sie erheblich beeinträchtigt. Für Vereine heißt das: Ein Modell darf vorschlagen, ein Mensch muss entscheiden und die Entscheidung begründen können.
Bei Minderjährigen gelten erhöhte Anforderungen an Transparenz. Eltern und Spieler sollten wissen, welche Daten erhoben werden, wofür und wie lange sie gespeichert bleiben. Leistungs- und Körperdaten können Gesundheitsdaten sein und brauchen dann in der Regel eine ausdrückliche Einwilligung.
Die europäische KI-Verordnung (AI Act) stuft KI-Systeme zur Auswahl von Bewerbern im Beschäftigungskontext als Hochrisiko ein. Ob das auf Scouting-Software für Profispieler zutrifft, die ja Arbeitnehmer werden, ist eine juristische Frage, die bislang nicht abschließend geklärt ist. Die Pflichten für solche Hochrisiko-Systeme gelten nach der im Juli 2026 in Kraft getretenen Änderung (Digital-Omnibus) ab dem 2. Dezember 2027. Für Amateurvereine mit Sichtungsbögen und Videoclips spielt das praktisch keine Rolle, die DSGVO dagegen sehr wohl. Mehr zu den Grundlagen im Beitrag zum Datenschutz im Jugendfußball.
So sichtet ein kleiner Verein strukturiert und fair
- Profil vor Spieler: Für jede Position zwei bis drei Aufgaben aus der Spielidee definieren, zum Beispiel „Ballannahme mit offenem Körper unter Druck“ beim Sechser.
- Einheitlicher Sichtungsbogen: Dieselben fünf bis sechs Kriterien für alle, mit kurzer Beobachtung statt Gesamteindruck.
- Mehrere Beobachter, mehrere Termine: mindestens zwei Personen und zwei Gelegenheiten, darunter ein Spiel.
- Video ergänzend: Kurze Clips der beobachteten Situationen sichern die Einschätzung ab und erlauben eine zweite Meinung.
- Geburtsquartal und Reife notieren: Ein spät geborener, kleinerer Spieler mit guter Spielintelligenz verdient eine zweite Sichtung.
- Entscheidung begründen und dokumentieren: Was hat überzeugt, was fehlte? Das hilft auch beim Feedback an Spieler und Eltern.
Für die Sichtung im Probetraining eignen sich Spielformen, in denen die gesuchten Aufgaben häufig vorkommen, etwa ein 4 gegen 4 plus 2 Neutrale für Sechser und Achter oder ein 2 gegen 2 auf Minitore für Verteidiger. Ideen dafür finden sich im Beitrag zu Spielformen im Fußballtraining.
Häufige Fragen
Wie funktioniert KI im Fußball-Scouting?
Modelle werten Ereignis- und Trackingdaten aus, vergleichen Spielerprofile und schlagen Kandidaten vor, deren Werte zu einer gesuchten Rolle passen. Zusätzlich sucht Software automatisch relevante Videoszenen heraus. Die Bewertung und Entscheidung bleiben bei Scouts und Trainern.
Welche Daten nutzen Scouts im Amateurfußball?
Meist eigene Videoaufnahmen, strukturierte Sichtungsbögen, Spielberichte und Beobachtungen bei Turnieren. Kommerzielle Ereignis- oder Trackingdaten gibt es für untere Ligen und Jugendklassen kaum. Wichtig ist, dass alle Beobachter dieselben Kriterien verwenden.
Was ist der relative Alterseffekt im Fußball?
Spieler, die früh im Auswahljahr geboren sind, werden in Jugendauswahlen deutlich häufiger berücksichtigt als spät geborene, weil sie körperlich und oft auch kognitiv einen Entwicklungsvorsprung haben. In deutschen U17- und U19-Bundesligakadern ist dieser Effekt gut belegt.
Können Daten im Jugendfußball Talente erkennen?
Nur begrenzt. Viele Messwerte bei 11- bis 15-Jährigen spiegeln Reife und relatives Alter wider. Daten helfen, die Kandidatenliste zu erweitern und Verzerrungen sichtbar zu machen; die Einschätzung von Spielverständnis und Lernfähigkeit braucht wiederholte Beobachtung.
Darf ein Verein Spieler automatisch von einer KI bewerten lassen?
Eine automatische Bewertung als Vorschlag ist möglich, wenn die Datenverarbeitung rechtmäßig ist und Betroffene informiert werden. Eine ausschließlich automatisierte Entscheidung mit erheblicher Wirkung, etwa eine Aufnahme oder Absage, ist nach Artikel 22 DSGVO grundsätzlich unzulässig; ein Mensch muss entscheiden.
Quellen
- Heilmann, Kuhlig, Stoll (2024): Relative age effects in German youth A and B men's soccer teams, Frontiers in Sports and Active Living
- Verordnung (EU) 2016/679 (DSGVO), Artikel 9 und 22
- Verordnung (EU) 2024/1689 (KI-Verordnung / AI Act)
- Hunton – EU Digital Omnibus on AI enters into force (neue Fristen für Hochrisiko-Systeme)
Geprüft im Oktober 2026. Regeln und Altersklassen variieren je nach Verband und Saison; prüfen Sie die örtlichen Bestimmungen.